Votre site est peut-être invisible pour ChatGPT, et personne ne vous l’a dit
De plus en plus de gens demandent conseil à un assistant IA au lieu de chercher sur Google. Mais si votre site bloque leurs robots, pour eux vous n’existez pas. Et souvent, ce blocage, ce n’est pas vous qui l’avez décidé.
Faites une expérience. Ouvrez ChatGPT, Gemini ou Perplexity et demandez-lui de vous conseiller une activité comme la vôtre, dans votre secteur géographique. Puis interrogez-le directement sur votre site : ce que vous proposez, combien ça coûte, quand vous êtes ouvert.
Si l’assistant répond avec des informations anciennes, génériques ou tirées d’autres sites, l’une des causes possibles est la plus simple de toutes : votre site ne le laisse pas entrer.
Une nouvelle façon de chercher
Pendant vingt ans, être trouvé voulait dire une seule chose : apparaître sur Google. Aujourd’hui, une part croissante des questions passe par un autre chemin. Les gens écrivent à un assistant IA ce qu’ils cherchent, avec leurs propres mots, et l’assistant répond en rassemblant ce qu’il a lu ici et là, souvent en citant ses sources.
Pour lire les sites, ces services utilisent des programmes automatiques, les robots d’exploration (crawlers), exactement comme Google. Chacun a son nom : GPTBot et OAI-SearchBot pour OpenAI, PerplexityBot pour Perplexity, Google-Extended pour les modèles de Google, et d’autres encore.
Chaque site indique à ces programmes ce qu’ils peuvent lire au moyen d’un petit fichier public, le robots.txt. S’il y est écrit de rester dehors, un robot respectueux suit l’indication. Et votre site, pour cet assistant, cesse d’exister comme source.
Le blocage que vous n’avez pas décidé
Jusque-là, rien d’anormal : bloquer les robots d’IA est un choix légitime. Le problème, c’est que très souvent ce n’est pas un choix.
Le cas le plus fréquent concerne Cloudflare, le service qui protège et accélère un très grand nombre de sites. Dans ses réglages pour les bots, il peut gérer automatiquement le robots.txt et bloquer les robots d’IA, et sur les sites les plus récents cette protection est souvent active par défaut. Le propriétaire du site ne reçoit aucune alerte : le site fonctionne, les visites arrivent, tout semble en ordre.
Le site est parfaitement visible pour Google et complètement invisible pour les assistants IA. Et personne ne s’en aperçoit.
La même chose peut arriver avec certaines extensions de sécurité, avec un robots.txt copié d’un vieux modèle ou avec une règle ajoutée il y a des années par la personne qui a construit le site, puis oubliée.
Comment le vérifier en deux minutes
Lisez votre robots.txt
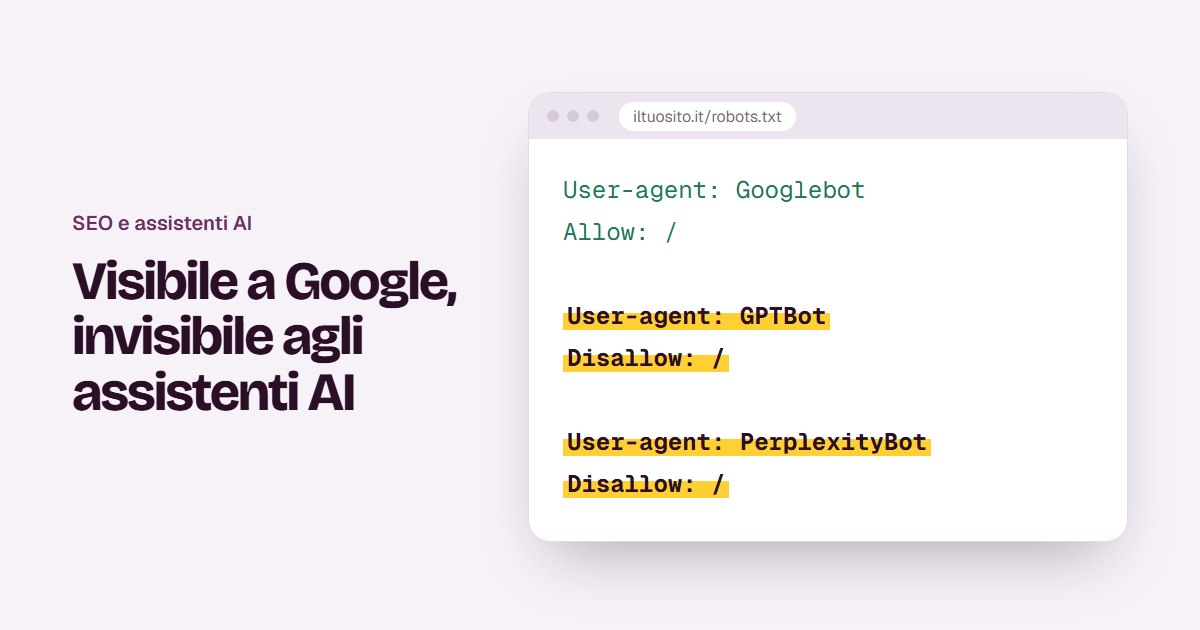
Ouvrez le navigateur et tapez l’adresse de votre site suivie de /robots.txt, par exemple iltuosito.it/robots.txt. Cherchez des lignes comme celles-ci :
Un blocage typique
User-agent: GPTBot
Disallow: /
Le nom après User-agent est le robot, et Disallow: / signifie « ne lis rien ». Si vous trouvez les noms des robots d’IA suivis de cette ligne, ces services ne lisent pas votre site.
Si vous utilisez Cloudflare, regardez les réglages des bots
Dans le panneau de Cloudflare, dans la section consacrée aux bots, vérifiez si le blocage des robots d’IA ou la gestion automatique du robots.txt est activé. C’est là que ça se décide, et c’est là que ça se change.
Ou confiez la vérification à un audit
Un audit qui mesure la visibilité IA lit le robots.txt à votre place, vous indique quels robots sont autorisés et lesquels sont bloqués, et signale le cas Cloudflare.
Bloquer ou laisser lire ?
Il n’existe pas de réponse valable pour tout le monde. Un journal qui vit de ses contenus peut avoir d’excellentes raisons de ne pas vouloir les laisser lire. Mais pour la plupart des activités, la question est autre : est-ce que je veux que ceux qui demandent conseil à un assistant IA me trouvent aussi ?
Pour un restaurant, un B&B, un cabinet ou une boutique, la réponse est presque toujours oui. Les informations que vous publiez, horaires, services, prix, adresse, existent justement pour que quelqu’un les trouve.
Certains services distinguent le robot qui collecte des textes pour entraîner les modèles de celui qui cherche des informations pour répondre en temps réel. Si vous voulez un compromis, vous pouvez laisser entrer les seconds et tenir les premiers à l’écart. L’important, c’est que la décision vous appartienne.
Et le fichier llms.txt ?
C’est une proposition récente : un fichier texte à la racine du site, écrit en Markdown, qui résume pour les assistants IA qui vous êtes, ce que vous proposez et où trouver les pages principales. Ce n’est pas un standard officiel et tous les services ne l’utilisent pas.
Il coûte pourtant très peu à préparer et n’a pas de contre-indication : c’est une façon ordonnée de dire aux assistants ce qui compte vraiment sur votre site.
Être lu ne suffit pas : il faut être cité
Ouvrir la porte aux robots est la première étape. Pour qu’un assistant utilise votre site comme source, le contenu doit aussi être facile à comprendre et à reprendre :
- Des réponses claires. Des pages qui répondent à une question précise, avec une phrase qu’on peut citer telle quelle : « Nous sommes ouverts du mardi au dimanche, de 12 h à 14 h 30 ».
- Des données structurées. Les informations décrites de façon compréhensible pour une machine : adresse, horaires, prix, questions fréquentes.
- De vraies questions fréquentes. Celles que vous recevez vraiment, pas celles que vous aimeriez recevoir.
En résumé
Vérifiez votre robots.txt dès aujourd’hui : deux minutes suffisent. Si vous trouvez les robots d’IA bloqués et que ce n’est pas votre décision, débloquez au moins ceux qui servent à répondre aux gens.
Pendant des années, nous nous sommes souciés de la façon dont Google nous voit. Il vaut désormais la peine de se demander aussi comment nous voient les assistants à qui les clients posent les mêmes questions.