Haz un experimento. Abre ChatGPT, Gemini o Perplexity y pídele que te recomiende un negocio como el tuyo, en tu zona. Después pregúntale directamente por tu web: qué ofrece, cuánto cuesta, cuándo abre.
Si el asistente responde con información antigua, genérica o sacada de otras webs, una de las causas posibles es la más simple de todas: tu web no le deja entrar.
Una nueva forma de buscar
Durante veinte años, que te encontraran significaba una sola cosa: salir en Google. Hoy una parte creciente de las preguntas va por otro camino. La gente le escribe a un asistente IA lo que busca, con sus propias palabras, y el asistente responde juntando lo que ha leído por ahí, a menudo citando las fuentes.
Para leer las webs, estos servicios usan programas automáticos, los crawlers, igual que hace Google. Cada uno tiene su nombre: GPTBot y OAI-SearchBot para OpenAI, PerplexityBot para Perplexity, Google-Extended para los modelos de Google, y otros más.
Cada web les dice a estos programas qué pueden leer mediante un pequeño archivo público, el robots.txt. Si ahí pone que se queden fuera, un crawler correcto lo respeta. Y tu web, para ese asistente, deja de existir como fuente.
El bloqueo que no has decidido tú
Hasta aquí nada raro: bloquear los crawlers de IA es una opción legítima. El problema es que muchas veces no es una opción elegida.
El caso más frecuente tiene que ver con Cloudflare, el servicio que protege y acelera muchísimas webs. En sus ajustes para bots puede gestionar automáticamente el robots.txt y bloquear los crawlers de IA, y en las webs más recientes esta protección suele venir activada de serie. El propietario de la web no recibe ningún aviso: la web funciona, llegan visitas, todo parece en orden.
La web es perfectamente visible para Google y completamente invisible para los asistentes IA. Y nadie se da cuenta.
Lo mismo puede pasar con algunos plugins de seguridad, con un robots.txt copiado de una plantilla antigua o con una regla que añadió hace años quien hizo la web y que luego quedó olvidada.
Cómo comprobarlo en dos minutos
Lee tu robots.txt
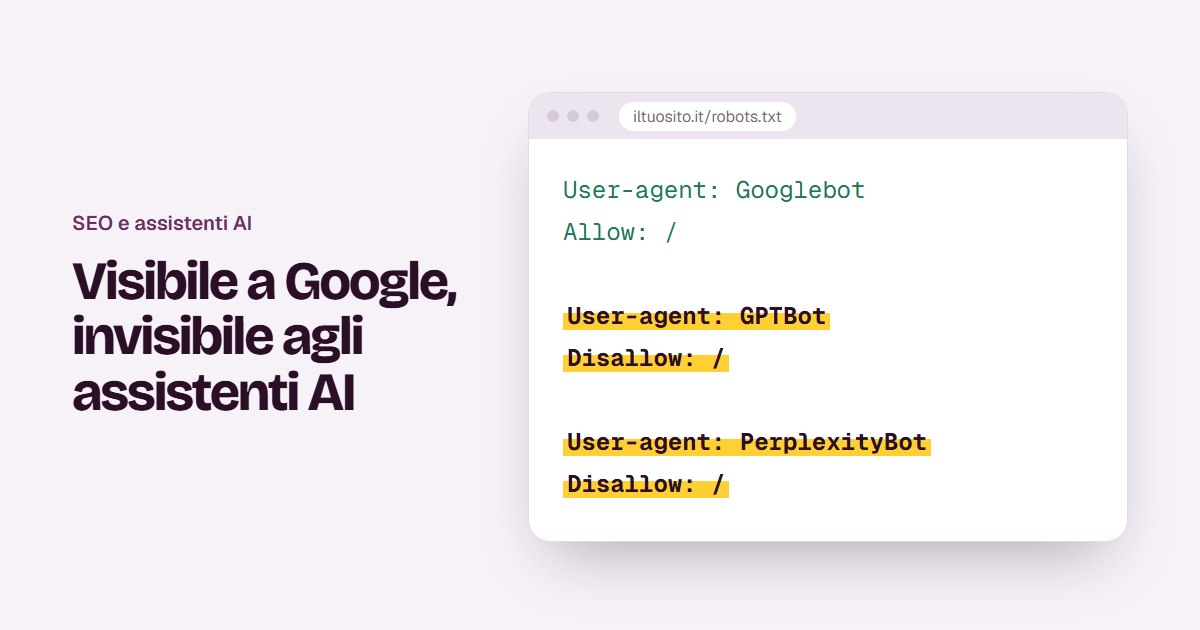
Abre el navegador y escribe la dirección de tu web seguida de /robots.txt, por ejemplo tusitio.es/robots.txt. Busca líneas como estas:
Un bloqueo típico
User-agent: GPTBot
Disallow: /
El nombre después de User-agent es el crawler, y Disallow: / significa «no leas nada». Si encuentras los nombres de los crawlers de IA seguidos de esta línea, esos servicios no leen tu web.
Si usas Cloudflare, mira los ajustes de bots
En el panel de Cloudflare, en la sección dedicada a los bots, comprueba si está activado el bloqueo de los crawlers de IA o la gestión automática del robots.txt. Ahí es donde se decide, y ahí es donde se cambia.
O deja que lo compruebe una auditoría
Una auditoría que mide la visibilidad en asistentes IA lee el robots.txt por ti, te dice qué crawlers están permitidos y cuáles bloqueados, y señala el caso de Cloudflare.
¿Bloquear o dejar leer?
No hay una respuesta válida para todos. Un medio de comunicación que vive de sus contenidos puede tener muy buenas razones para no querer que los lean. Pero para la mayoría de los negocios la pregunta es otra: ¿quiero que quien pide consejo a un asistente IA también me encuentre a mí?
Para un restaurante, un B&B, un despacho profesional o una tienda, la respuesta es casi siempre sí. La información que publicas, horarios, servicios, precios, dónde estás, existe precisamente para que alguien la encuentre.
Algunos servicios distinguen entre el crawler que recoge textos para entrenar los modelos y el que busca información para responder en tiempo real. Si quieres un término medio, puedes dejar entrar a los segundos y dejar fuera a los primeros. Lo importante es que lo decidas tú.
¿Y el archivo llms.txt?
Es una propuesta reciente: un archivo de texto en la raíz de la web, escrito en Markdown, que resume para los asistentes IA quién eres, qué ofreces y dónde encontrar las páginas principales. No es un estándar oficial y no todos los servicios lo usan.
Pero prepararlo cuesta muy poco y no tiene contraindicaciones: es una forma ordenada de decirles a los asistentes qué importa de verdad en tu web.
Que te lean no basta: tienen que citarte
Abrir la puerta a los crawlers es el primer paso. Para que un asistente use tu web como fuente, el contenido también tiene que ser fácil de entender y de reproducir:
- Respuestas claras. Páginas que responden a una pregunta concreta, con una frase que se pueda citar tal cual: «Abrimos de martes a domingo, de 12:00 a 14:30».
- Datos estructurados. La información descrita de forma que una máquina la entienda: dirección, horarios, precios, preguntas frecuentes.
- Preguntas frecuentes de verdad. Las que recibes realmente, no las que te gustaría recibir.
En resumen
Revisa tu robots.txt hoy mismo: bastan dos minutos. Si encuentras los crawlers de IA bloqueados y no lo has decidido tú, desbloquea al menos los que sirven para responder a la gente.
Durante años nos hemos preocupado por cómo nos ve Google. Ahora también merece la pena preguntarse cómo nos ven los asistentes a los que los clientes hacen las mismas preguntas.