- Startseite
- Blog
- SEO und KI
Ihre Website ist für ChatGPT vielleicht unsichtbar, und niemand hat es Ihnen gesagt
Immer mehr Menschen fragen einen KI-Assistenten um Rat, statt bei Google zu suchen. Blockiert Ihre Website deren Crawler, existieren Sie für sie nicht. Und oft haben nicht Sie diese Sperre beschlossen.
Machen Sie ein Experiment. Öffnen Sie ChatGPT, Gemini oder Perplexity und lassen Sie sich einen Betrieb wie Ihren in Ihrer Gegend empfehlen. Fragen Sie dann direkt nach Ihrer Website: was Sie anbieten, was es kostet, wann Sie geöffnet haben.
Antwortet der Assistent mit veralteten, allgemeinen oder von anderen Websites übernommenen Informationen, kann eine der Ursachen die einfachste von allen sein: Ihre Website lässt ihn nicht herein.
Eine neue Art zu suchen
Zwanzig Jahre lang hieß gefunden werden nur eines: bei Google erscheinen. Heute nimmt ein wachsender Teil der Fragen einen anderen Weg. Menschen schreiben einem KI-Assistenten mit eigenen Worten, was sie suchen, und der Assistent antwortet mit dem, was er gelesen hat, oft mit Quellenangabe.
Um Websites zu lesen, nutzen diese Dienste automatische Programme, sogenannte Crawler, genau wie Google. Jeder hat seinen Namen: GPTBot und OAI-SearchBot für OpenAI, PerplexityBot für Perplexity, Google-Extended für die Modelle von Google und weitere.
Jede Website teilt diesen Programmen über eine kleine öffentliche Datei mit, was sie lesen dürfen: die robots.txt. Steht dort, dass sie draußen bleiben sollen, hält sich ein korrekter Crawler daran. Und Ihre Website existiert für diesen Assistenten nicht mehr als Quelle.
Die Sperre, die Sie nicht beschlossen haben
So weit nichts Ungewöhnliches: KI-Crawler zu blockieren ist eine legitime Entscheidung. Das Problem ist, dass es sehr oft keine Entscheidung ist.
Der häufigste Fall betrifft Cloudflare, den Dienst, der sehr viele Websites schützt und beschleunigt. In seinen Bot-Einstellungen kann er die robots.txt automatisch verwalten und KI-Crawler blockieren, und bei neueren Websites ist dieser Schutz oft standardmäßig aktiv. Der Betreiber erhält keinen Hinweis: Die Website funktioniert, Besuche kommen, alles scheint in Ordnung.
Die Website ist für Google bestens sichtbar und für KI-Assistenten völlig unsichtbar. Und niemand merkt es.
Dasselbe kann mit manchen Sicherheits-Plugins passieren, mit einer robots.txt aus einer alten Vorlage oder mit einer Regel, die der Ersteller der Website vor Jahren eingefügt und dann vergessen hat.
So prüfen Sie es in zwei Minuten
Lesen Sie Ihre robots.txt
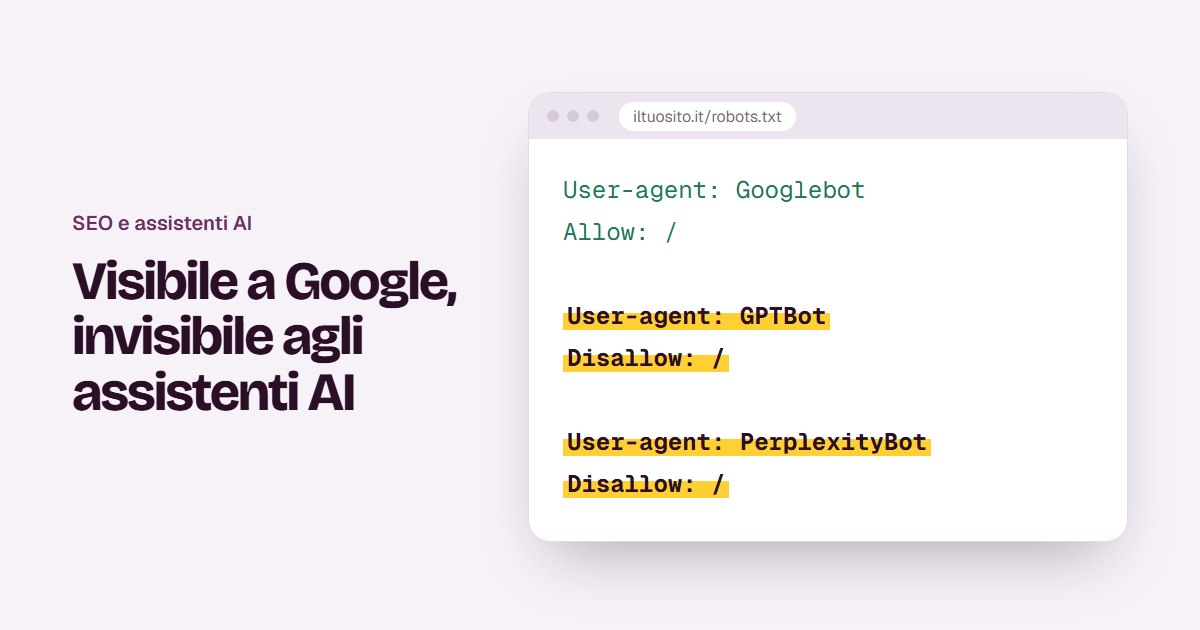
Öffnen Sie den Browser und geben Sie die Adresse Ihrer Website gefolgt von /robots.txt ein, zum Beispiel ihre-website.de/robots.txt. Suchen Sie nach Zeilen wie diesen:
Eine typische Sperre
User-agent: GPTBot
Disallow: /
Der Name nach User-agent ist der Crawler, und Disallow: / bedeutet „nichts lesen“. Finden Sie die Namen von KI-Crawlern mit dieser Zeile, lesen diese Dienste Ihre Website nicht.
Nutzen Sie Cloudflare, prüfen Sie die Bot-Einstellungen
Prüfen Sie im Cloudflare-Dashboard im Bereich für Bots, ob die Sperre für KI-Crawler oder die automatische robots.txt-Verwaltung aktiv ist. Dort wird es entschieden, und dort ändern Sie es.
Oder lassen Sie ein Audit prüfen
Ein Audit, das die KI-Auffindbarkeit misst, liest die robots.txt für Sie, listet zugelassene und blockierte Crawler auf und weist auf den Cloudflare-Fall hin.
Blockieren oder lesen lassen?
Es gibt keine Antwort, die für alle gilt. Ein Nachrichtenmedium, das von seinen Inhalten lebt, kann gute Gründe haben, sie nicht lesen zu lassen. Für die meisten Betriebe lautet die Frage aber anders: Will ich, dass mich auch findet, wer einen KI-Assistenten um Rat fragt?
Für ein Restaurant, ein B&B, eine Kanzlei oder einen Laden lautet die Antwort fast immer ja. Die Informationen, die Sie veröffentlichen, also Öffnungszeiten, Leistungen, Preise, Standort, gibt es genau dafür, dass jemand sie findet.
Manche Dienste unterscheiden zwischen dem Crawler, der Texte zum Training der Modelle sammelt, und dem, der Informationen für Antworten in Echtzeit sucht. Wollen Sie einen Mittelweg, lassen Sie die zweiten herein und halten die ersten draußen. Wichtig ist, dass es Ihre Entscheidung ist.
Und die Datei llms.txt?
Ein neuer Vorschlag: eine Textdatei im Stammverzeichnis der Website, in Markdown geschrieben, die KI-Assistenten zusammenfasst, wer Sie sind, was Sie anbieten und wo die wichtigsten Seiten stehen. Sie ist kein offizieller Standard, und nicht alle Dienste nutzen sie.
Sie ist aber mit sehr wenig Aufwand erstellt und hat keine Nachteile: eine geordnete Art, Assistenten zu sagen, was auf Ihrer Website wirklich zählt.
Gelesen werden reicht nicht: Sie müssen zitiert werden
Den Crawlern die Tür zu öffnen ist der erste Schritt. Damit ein Assistent Ihre Website als Quelle nutzt, müssen die Inhalte auch leicht zu verstehen und wiederzugeben sein:
- Klare Antworten. Seiten, die eine konkrete Frage beantworten, mit einem Satz, der sich so zitieren lässt: „Wir haben von Dienstag bis Sonntag von 12 bis 14:30 Uhr geöffnet.“
- Strukturierte Daten. Informationen, die so beschrieben sind, dass eine Maschine sie versteht: Adresse, Öffnungszeiten, Preise, häufige Fragen.
- Echte häufige Fragen. Die, die Sie wirklich erhalten, nicht die, die Sie gern erhalten würden.
Zusammengefasst
Prüfen Sie Ihre robots.txt noch heute: Es dauert zwei Minuten. Sind KI-Crawler blockiert und haben Sie das nicht selbst entschieden, geben Sie zumindest die frei, die Menschen Antworten liefern.
Jahrelang haben wir uns gefragt, wie Google uns sieht. Jetzt lohnt sich auch die Frage, wie uns die Assistenten sehen, denen Kunden dieselben Fragen stellen.