Prova a fare un esperimento. Apri ChatGPT, Gemini o Perplexity e chiedi di consigliarti un’attività come la tua, nella tua zona. Poi chiedi direttamente del tuo sito: cosa offre, quanto costa, quando è aperto.
Se l’assistente risponde con informazioni vecchie, generiche o prese da altri siti, una delle cause possibili è la più semplice di tutte: il tuo sito non lo lascia entrare.
Un nuovo modo di cercare
Per vent’anni farsi trovare ha voluto dire una cosa sola: comparire su Google. Oggi una parte crescente delle domande passa da un’altra strada. Le persone scrivono a un assistente AI quello che cercano, con parole loro, e l’assistente risponde mettendo insieme quello che ha letto in giro, spesso citando le fonti.
Per leggere i siti, questi servizi usano dei programmi automatici, i crawler, proprio come fa Google. Ognuno ha il suo nome: GPTBot e OAI-SearchBot per OpenAI, PerplexityBot per Perplexity, Google-Extended per i modelli di Google, e altri ancora.
Ogni sito dice a questi programmi cosa possono leggere attraverso un piccolo file pubblico, il robots.txt. Se lì dentro c’è scritto di stare fuori, un crawler corretto rispetta l’indicazione. E il tuo sito, per quell’assistente, smette di esistere come fonte.
Il blocco che non hai deciso tu
Fin qui niente di strano: bloccare i crawler AI è una scelta legittima. Il problema è che molto spesso non è una scelta.
Il caso più frequente riguarda Cloudflare, il servizio che protegge e velocizza moltissimi siti. Nelle sue impostazioni per i bot può gestire in automatico il robots.txt e bloccare i crawler AI, e sui siti più recenti questa protezione è spesso attiva di serie. Il proprietario del sito non riceve nessun avviso: il sito funziona, le visite arrivano, tutto sembra in ordine.
Il sito è perfettamente visibile a Google e completamente invisibile agli assistenti AI. E nessuno se ne accorge.
Lo stesso può succedere con alcuni plugin di sicurezza, con un robots.txt copiato da un vecchio modello o con una regola aggiunta anni fa da chi ha costruito il sito e poi dimenticata.
Come controllarlo in due minuti
Leggi il tuo robots.txt
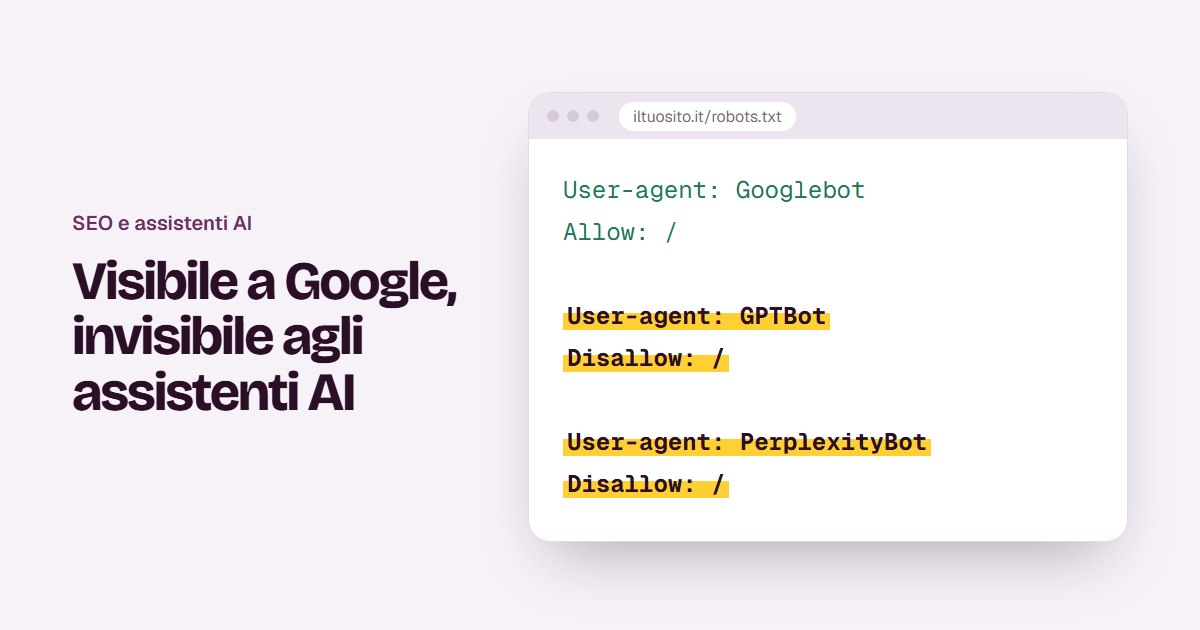
Apri il browser e scrivi l’indirizzo del tuo sito seguito da /robots.txt, per esempio iltuosito.it/robots.txt. Cerca righe come queste:
Un blocco tipico
User-agent: GPTBot
Disallow: /
Il nome dopo User-agent è il crawler, e Disallow: / vuol dire «non leggere niente». Se trovi i nomi dei crawler AI seguiti da questa riga, quei servizi non leggono il tuo sito.
Se usi Cloudflare, guarda le impostazioni dei bot
Nel pannello di Cloudflare, nella sezione dedicata ai bot, controlla se è attivo il blocco dei crawler AI o la gestione automatica del robots.txt. È lì che si decide, ed è lì che si cambia.
Oppure fai fare il controllo a un audit
Un audit che misura la trovabilità AI legge il robots.txt per conto tuo, ti elenca quali crawler sono ammessi e quali bloccati e segnala il caso Cloudflare.
Bloccare o lasciar leggere?
Non esiste una risposta valida per tutti. Una testata giornalistica che vive dei propri contenuti può avere ottime ragioni per non volerli far leggere. Ma per la maggior parte delle attività la domanda è un’altra: voglio che chi chiede consiglio a un assistente AI trovi anche me?
Per un ristorante, un B&B, uno studio professionale o un negozio la risposta è quasi sempre sì. Le informazioni che pubblichi, orari, servizi, prezzi, dove sei, esistono proprio perché qualcuno le trovi.
Alcuni servizi distinguono tra il crawler che raccoglie testi per addestrare i modelli e quello che cerca informazioni per rispondere in tempo reale. Se vuoi una via di mezzo, puoi lasciare entrare i secondi e tenere fuori i primi. L’importante è che sia una decisione tua.
E il file llms.txt?
È una proposta recente: un file di testo nella radice del sito, scritto in Markdown, che riassume per gli assistenti AI chi sei, cosa offri e dove trovare le pagine principali. Non è uno standard ufficiale e non tutti i servizi lo usano.
Costa però pochissimo prepararlo e non ha controindicazioni: è un modo ordinato di dire agli assistenti cosa conta davvero nel tuo sito.
Farsi leggere non basta: bisogna farsi citare
Aprire la porta ai crawler è il primo passo. Perché un assistente usi il tuo sito come fonte, il contenuto deve anche essere facile da capire e da riportare:
- Risposte chiare. Pagine che rispondono a una domanda precisa, con una frase che si può citare così com’è: «Siamo aperti dal martedì alla domenica, dalle 12 alle 14:30».
- Dati strutturati. Le informazioni descritte in modo che una macchina le capisca: indirizzo, orari, prezzi, domande frequenti.
- Domande frequenti vere. Quelle che ricevi davvero, non quelle che ti piacerebbe ricevere.
In sintesi
Controlla il tuo robots.txt oggi stesso: bastano due minuti. Se trovi i crawler AI bloccati e non l’hai deciso tu, sblocca almeno quelli che servono a rispondere alle persone.
Per anni ci siamo preoccupati di come ci vede Google. Adesso vale la pena chiedersi anche come ci vedono gli assistenti a cui i clienti fanno le stesse domande.